Het woord zoeken verwijst niet langer naar één pagina met blauwe links. Het staat voor Google, ChatGPT, Perplexity, Gemini, Apple Maps, TikTok en een groeiende lijst AI-assistenten die antwoorden synthetiseren in plaats van ze op te sommen. Voor merken is de verleiding groot om elk kanaal te behandelen als een afzonderlijke campagne met een eigen budgetregel en een eigen consultant. Na een jaar lang te hebben gezien hoe dit uitpakt bij klantaccounts, zijn we ervan overtuigd dat dit de verkeerde reflex is. De mechanismen verschillen, maar de fundamenten lopen uit op één ding: informatie publiceren die machines kunnen verifiëren en die mensen daadwerkelijk willen lezen.
De mythe van een aparte AI-strategie
Er is een hele industrie ontstaan rond "AEO" en "GEO" — answer engine optimisation en generative engine optimisation — aangeboden als aparte disciplines met eigen playbooks. Google zelf heeft die premisse stilletjes onderuitgehaald en beschrijft zoeken en zijn AI-agenten als één product dat op één set signalen is gebouwd. Als je inzoomt op hoe tools zoals ChatGPT daadwerkelijk een antwoord samenstellen, wordt het beeld nog scherper.
Analyse van het netwerkverkeer achter deze systemen — in plaats van de gepolijste output — onthult iets leerzaams. AI-modellen verzinnen geen autoriteit. Ze steunen op crawlbare feiten, validatie door derden en live zoekopdrachten die worden geactiveerd door specifieke queries. Als jouw productdata, prijzen of expertise niet toegankelijk zijn en nergens anders op het open web worden bevestigd, heeft het model niets concreets om naar te verwijzen. De les is ontnuchterend voor iedereen die geheime GEO-hacks verkoopt: er bestaat geen prompt-fluister-truc. Er is alleen écht vindbaar en écht betrouwbaar zijn.
Wat machines wel en niet kunnen zien
De praktische implicaties zijn concreet:
- Crawlbaarheid bepaalt nog altijd alles. Als cruciale feiten zijn opgesloten in JavaScript, pdf's of afbeeldingen zonder gestructureerde markup, komen ze mogelijk nooit in de kennis van het model terecht.
- Bevestiging door derden telt zwaarder dan eigenwijs zelfpromotie. Een bewering die door meerdere gerenommeerde onafhankelijke bronnen wordt herhaald, heeft gewicht; een bewering die alleen op jouw eigen site staat, niet.
- Triggers op queryniveau bepalen wanneer live search wordt geactiveerd. Sommige vragen trekken verse webresultaten op, andere steunen op trainingsdata. Begrijpen wat wat is, bepaalt waar jouw investering loont.
Fragmentatie is echt, maar de reactie is eensgezind
Voor merken met meerdere locaties is zichtbaarheid verspreid geraakt over Google Business Profielen, AI-assistenten die nabijgelegen opties aanbevelen, social discovery en navigatie-apps die "nu open"-zoekopdrachten beantwoorden voordat iemand een browser aanraakt. Deze fragmentatie is reëel en vraagt om operationele discipline — consistente NAP-data, schone lokale gestructureerde markup en per locatie bijgehouden recensies.
Maar let op: geen van deze tactieken spreekt de andere tegen. Nauwkeurige, goed gestructureerde, bevestigde locatiedata voedt tegelijkertijd Googles lokale pack, AI-aanbevelingen en kaart-apps. Je bouwt niet aan vier strategieën. Je bouwt aan één schone datalaag die meerdere oppervlakken consumeren. Dat is het patroon overal: de oppervlakken vermenigvuldigen zich, de fundamenten niet.
Content die mensen daadwerkelijk willen lezen
Google is de laatste tijd ongewoon direct: uitgevers die willen overleven in AI-zoeken moeten content maken die gebruikers daadwerkelijk willen lezen. Het klinkt zo vanzelfsprekend dat het bijna nutteloos lijkt, maar het gaat in tegen tien jaar SEO-gewoontes. Dunne, op sjablonen gebaseerde pagina's die puur zijn opgezet voor rankingsignalen waren altijd al kwetsbaar. In een door AI bemiddelde resultatenomgeving zijn ze erger dan kwetsbaar — ze bieden niets dat de moeite waard is om te tonen, omdat een model die generieke samenvatting zelf kan genereren.
De content die nu citaten en verwijzingen verdient, bevat doorgaans informatie die een model niet zelf kan synthetiseren: originele data, eerstehands ervaringen, specifieke cijfers, echte expertise. Dit is waar kleine uitgevers onverwacht ruimte kunnen vinden. Google's Liz Reid heeft betoogd dat personalisatie en signalen van voorkeursbronnen kleinere sites kunnen helpen gevonden te worden in AI-zoeken — hoewel ze er opvallend genoeg geen data bij leverde om de claim te onderbouwen. Wij beschouwen het als een bemoedigende richting, niet als een bewezen strategie. De veiligste keuze blijft onderscheidende, verifieerbare content boven volume.
Ook de handhaving wordt strenger
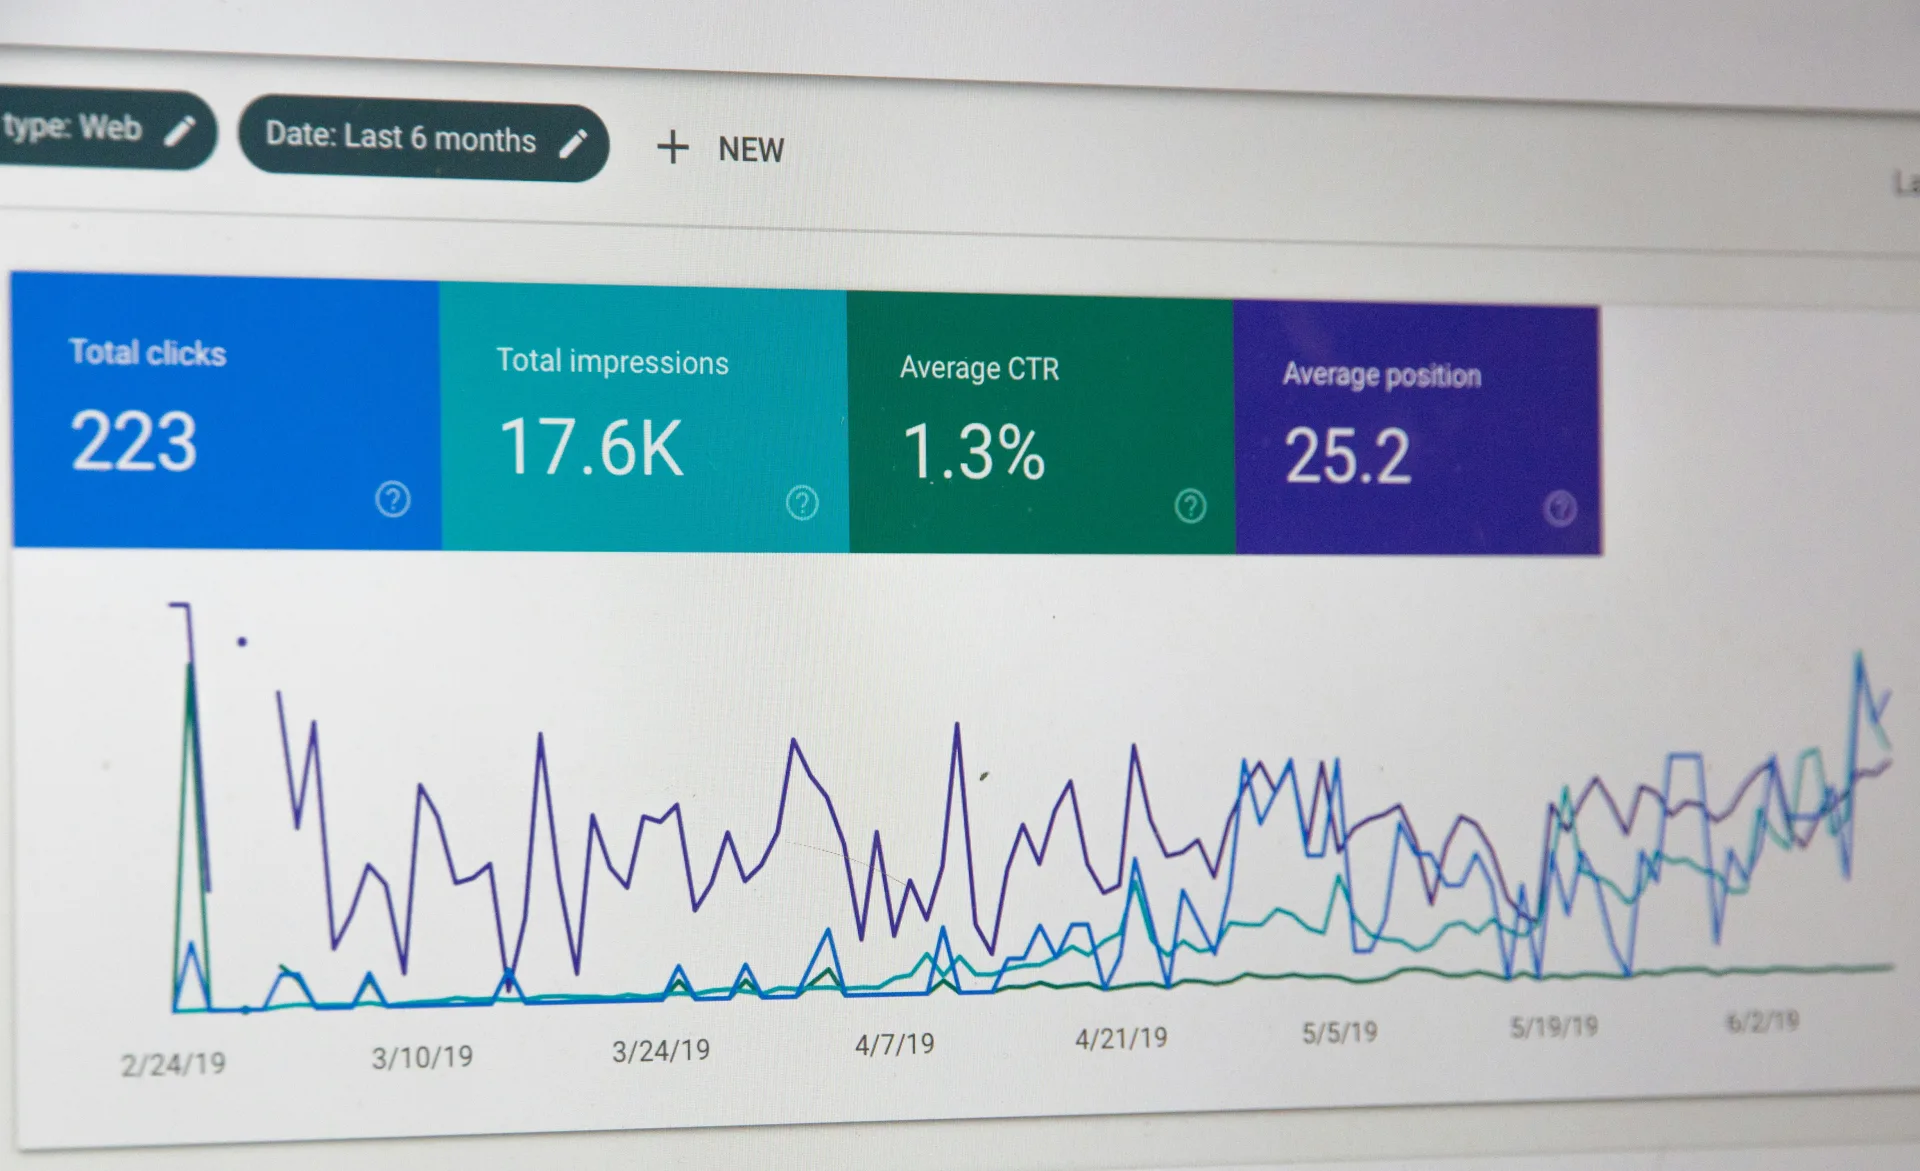
Iedereen die in de verleiding komt om deze systemen te manipuleren, moet weten dat de regels tegelijkertijd worden aangescherpt. Google's recente spam-update heeft AI-gedreven manipulatie expliciet in het vizier gebracht, gericht op de vloed van met weinig moeite gegenereerde content die wordt geproduceerd om zichtbaarheid te jagen. Daarbij worstelt de industrie met nieuwe meetvragen: hoe AI-impressies worden geteld, hoe klikgedrag eruitziet wanneer antwoorden direct op het scherm verschijnen, en bewijs van aanbieders zoals Similarweb dat suggereert dat merkgebonden zoekpatronen verschuiven nu gebruikers rechtstreeks assistenten bevragen.
Hieruit volgen twee dingen. Ten eerste moeten meetkaders die zijn gebouwd voor klassiek zoeken worden bijgewerkt — jouw dashboards onderschatten waarschijnlijk door AI gestuurde ontdekking en wegen traditionele klikken te zwaar. Ten tweede sluit het manipulatiegat zich sneller dan de meeste operators verwachten. Bouwen op shortcuts die een spam-update in één nacht kan wissen is geen strategie; het is een risico.
Wat we klanten aanbevelen
De rode draad is eenvoudiger dan de ruis doet vermoeden. In plaats van afzonderlijke AI-, lokale en organische programma's in te zetten, raden we aan één duurzame basis te bouwen:
- Maak je feiten machine-leesbaar en extern geverifieerd — gestructureerde data, consistente entiteitsinformatie en aanwezigheid in bronnen die modellen vertrouwen.
- Investeer in content die alleen jij kunt produceren — eigen data, echte expertise, specifieke antwoorden op echte vragen.
- Onderhoud één schone datalaag die elk oppervlak — van Google tot Gemini tot Maps — kan consumeren.
- Herbouw je meetmethode om AI-impressies en door assistenten gestuurde ontdekking te meten, niet alleen traditionele klikken.
De kanalen blijven zich vermenigvuldigen, en de verkopers van kanaalspecifieke wonderstrategieën blijven dat ook doen. De merken die de volgende fase van zoeken winnen, zijn niet degenen met de meeste playbooks. Het zijn de merken waarvan de informatie zo toegankelijk, geloofwaardig en oprecht nuttig is dat elk systeem — menselijk of machinaal — een gemakkelijke reden heeft om die te tonen.
Bronnen
- How ChatGPT Actually Picks Sources (I Read The Network Traffic, Not The Outputs) via @sejournal, @suganthan — Search Engine Journal
- Multi-Location Search Visibility: Winning In Google & AI via @sejournal, @seosteve — Search Engine Journal
- Google's Liz Reid: Personalization Can Help Small Publishers via @sejournal, @MattGSouthern — Search Engine Journal
- Search And Agents Are One Product. You Only Need One Playbook via @sejournal, @slobodanmanic — Search Engine Journal
- Google Says AI Visibility Hinges On Content People Actually Want To Read via @sejournal, @martinibuster — Search Engine Journal
- Google Spam Update Rolls Out, AI Manipulation In Scope – SEO Pulse via @sejournal, @MattGSouthern — Search Engine Journal